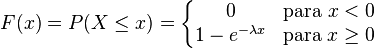Mostrando entradas con la etiqueta Modelado y simulación de Sistemas dinámicos. Mostrar todas las entradas

martes, 1 de mayo de 2012

Simulación de Ambiente Urbano

Simulación de Medio Ambiente Urbano

A medida que más se presta atención a la planificación urbana "verde", la necesidad de estudios de simulación del medio ambiente ha crecido de forma espectacular. Gobierno y la planificación empresarial son a la vez que impulsa la necesidad de la evaluación de los edificios de efectos, y paisajes urbanos completos, en el medio ambiente. Esto es especialmente cierto para los efectos solares.

A medida que el costo del combustible sigue aumentando, el costo de refrigeración de los edificios comerciales se está convirtiendo en una preocupación importante. Además, como el costo de la energía solar conversión de las caídas, esta fuente ilimitada de energía está siendo rápidamente diseñados en la planificación del nuevo edificio. El programa de la certificación LEED (Liderazgo en Energía y Diseño Ambiental) fue desarrollado para proporcionar una herramienta de calificación práctica para el diseño de edificios verdes e incorpora la selección de materiales, eficiencia energética y calidad ambiental interior. De simulación solar puede proporcionar datos muy valiosos para ayudar a todos estos retos aplicaciones.


Este sistema de simulación se ha instalado para ayudar en el desarrollo de herramientas de software de análisis para permitir la simulación de análisis de la "isla de calor" fenómeno experimentado en los entornos urbanos. Eye Iluminación / Iwasaki trabajó con este cliente para crear un sistema extremadamente flexible que permite que el calor programable (irradiación) de carga en un túnel de viento térmico estratificado. Las lámparas también pueden ser articulados para proporcionar un ángulo de inclinación de hasta 45 grados para simular la luz del sol por la mañana y la tarde.


Eyes / Iwasaki Sistemas Ambientales de simulación solar


  • Iwasaki tecnología patentada de Solarlux las luces cumplan los requisitos de la norma espectral de energía de la EPA distribución y simular un entorno de luz cerca de la luz del sol real.
  • La insolación puede ser fijado y controlado entre 600 y 1.150 W/m2.
  • La razón de uniformidad de la insolación cumple plenamente la norma de la EPA de dentro de ± 15%.
  • Las lámparas de iluminación dentro de la matriz puede ser articulado + / - 45 grados para simular la mañana / tarde la luz del sol.
  • Patrones programables de iluminación se puede emplear para simular patrones específicos de irradiación y reducir aún más el nivel de irradiación.

Referencias

viernes, 20 de abril de 2012

jueves, 19 de abril de 2012

Clase 19 abril

Ecuaciones diferenciales


GRAFICAS PENDIENTES PARA EL PROX JUEVES :)

Sistemas caóticos - Crecimiento de plantas

Los sistemas caóticos son sistemas impredecibles,se refiere a la complejidad que es causada por la relación entre eventos sin que se vea una traza lineal que relacione la causa con el efecto, si no más bien un complejo calculo.

Es imposible saber las variaciones y es por eso que no podemos conocer con exactitud los acontecimientos futuros. Como no se puede saber los valores de las variables que afectan, se dice que es un sistema caótico en donde cualquier evento por insignificante que sea tiene el poder de cambiar el sistema por completo.
En matemáticas podemos decir que el caos es un comportamiento determinismo aperiodico sensible a las condiciones iniciales.

Crecimiento de plantas caótico


La estructura de muchas plantas es caótica, ya que cada rama se genera con una cierta probabilidad, y tiene cierta probabilidad de que muera o viva, o de que se sustituya por una hoja o flor.
Las funciones pueden llegar a contar con muchos tipos de distribuciones y los parametros pueden tomar valores en espacios discretos o continuos. Entonces con esto podemos ver que ya con pocas cosas mencionadas estamos armando todo un 'caos'.

La naturaleza es caótica (no ordenada y tampoco desordenada), por ejemplo, modelar un problema real mediante un sistema ordenado sería como representar iguales a todos los árboles que hay en un bosque. Pero en la vida real esto no sucede así, cada árbol, cada hoja de un árbol es diferente y hermosos, y eso es CAOS!!.

La generación de plantas de manera ordenada es romper la esencia de la realidad, es por eso que tenemos que modelar sistemas caóticos, y aprender a que las variables pueden tomar valores en forma aleatoria y esos valores son válidos.

Como ya lo mencioné antes el crecimiento de plantas se puede modelar computacionalmente usando variables aleatorias, que en la naturaleza la pueden llegar a determinar el clima, la cantidad de nutrientes,  viento, calidad de suelo, plagas, etc. Computacionalmente se hace eligiendo un valor pseudoaleatorio y de este valor partimos para elegir algún crecimiento en la planta, ya sea la inclinación, tamaño de las hojas, altura, ancho, forma, etc., que cada uno de esos factores serán representado por ecuaciones, en resumen se escogerá un valor al azar y con el se podrá elegir alguna ecuación que decida la estructura de la planta a construir, esta ecuación nos dará valores de salida "x" y "y" y de ellos dependeremos para el siguiente paso, sin embargo el siguiente paso será nuevamente determinado por una variable aleatoria y se podrá elegir de nuevo una ecuación que defina la estructura de la planta, y así sucesivamente.

Para modelar este sistema yo usé algo a que se llama algoritmo de iteración aleatoria que también es llamado juego del caos  concretamente el llamado Barnsley fern en donde un puntos que van dibujandose aparentemente aleatorios van formando progresivamente la figura del atractor. Con esto se elige el punto x0 del espacio y se forma una sucesión en donde cada paso se escoge aleatoriamente con alguna probabilidad.


Ese algoritmo asigna diferentes probabilidades a cada Fi. Con estas probabilidades se puede obtener diferentes TEXTURAS y DENSIDADES, muy útiles para modelar escenas naturales.

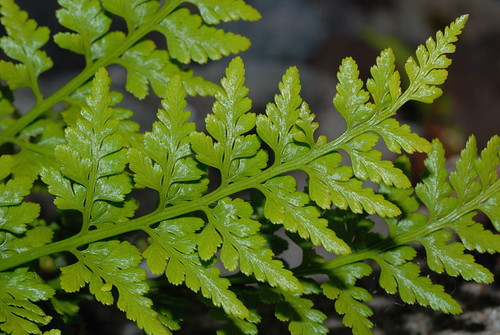
Black Spleenwort

El helecho de Barnsley utiliza cuatro transformaciones afines. La fórmula para una transformación es la siguiente:


Los valores de la tabla de abajo muestran valores, para producir la planta Black Spleenwort. En la tabla a y b corresponden a valores de coeficientes para x y y, del mismo x y y nuevo, f es el coeficiente y la p es la probabilidad de usar esa ecuación.

Imagen de Wikipedia
Poniéndolos en la matriz, vemos algo como esto:

Imagen de Wikipedia

Esto quiere decir que la probabilidad de usar F1 es de 1%, la de usar F2 es de 85%, la de usar F3 es la de 7% y F4 también 7%.


Imagen de wikipedia

La F1 se encarga de sólo mapear cualquier punto a un punto en el primer segmento de línea en la base del tallo.
La F2 mapea cualquier punto dentro del prospecto representado por el triángulo de color rojo, más pequeño representado por el triángulo azul en la figura.
La F3 dibuja de cualquier punto dentro de la hoja (o pabellón auricular), representado por el triángulo azul.
Y la F4 dibuja cualquier punto dentro de la hoja, representado por el triángulo azul a un punto dentro del triángulo alterna a través de el tallo.

En resumen a transformación de coordenadas primero señala a el tallo. La segunda genera copias sucesivas del tallo y hojas de fondo para hacer la completa helecho. La tercera señala a la fronda de abajo a la izquierda. La cuarta señala a la fronda de abajo a la derecha. La naturaleza recursiva de la IFS garantiza que el todo es una réplica más grande de cada fronda. El helecho está dentro del rango -2,1818 = x = 2,6556 y 0 = y = 9,95851.

El código lo he generado en python con los valores de coeficientes ya mencionados, y las variables correspondientes a cada ecuación para generar :


Ahora lo corro, y creo un archivo que guarde las salidas, que son los valroes de x y y para después graficarlos con Gnuplot.


Abro GNUPLOT y :


Y obtengo una salida como esta:

Con 10000 iteraciones:


Con 100000 iteraciones:


Con 1000000 iteraciones


Resultados cambiando coeficientes:

Cambiando la parte de coeficientes así:


Esta es la imágen que se obtiene:


Otro:


Y se obtiene:


Y con los coeficientes:


Resultado:


Y así podemos cambiar los coeficientes de las ecuaciones y aunque sean pequeños los cambios podremos ver cambios en las figuras que forman como las siguientes:

Este forma un helecho bastante curvo:


Acá se muestra una figura muy parecida a un caracol:


Con esto podemos ver el porque la formación de plantas es caótica, diversos factores influyen en las plantas como el clima, agua, sombra, sol, viento que por pequeños que sean esos factores influyen fuertemente en sus estructuras finales.


L-system

Pensaba terminar con el tema ya con eso mostrado pero me encontré con otra manera de simular el crecimiento de plantas que es diferente al pasado, lo que se hace con este es crear cadenas

Un sistema de Lindenmayer es una gramática formal (un conjunto de reglas y símbolos) que se usan principalmente para modelar el proceso de crecimiento de las plantas; y tambien modela la morfología de una variedad de organismos. Los sistemas-L se utilizan además para generar fractales autosimilares como los sistemas de función iterada. Los sistemas-L se desarrollaron en 1968 por el biólogo y botánico teórico húngaro Aristid Lindenmayer de la Universidad de Utrecht (1925-1989).
Yo use el generador con las siguientes reglas:


Con eso podemos formar la estructura de una planta, tomando en cuenta que cada caracter de la cadena significa algún movimiento.


Yo desarrolle el siguiente código:


Resultado:


Ahora grafiqué esto de alguna manera, la primera forma que pensé fue hacerlo tipo "tortuga" que moviera ángulos o cosas así pero como tengo poco tiempo, lo hice de otras maneras la primera fué que cada letra tenía un valor y se graficaban todos sus valores, entonces modifiqué el código así:


Resultado:


Y la otra forma que hice fue hacer una variable a la que se le sume o reste cierto número según el carácter de la cadena:


Resultado:


Y podemos ver como la figura entera esta compuesta de pequeñas formas con la misma figura, esto es la naturaleza fractal de las plantas que representan este modelo.


Fuentes

Fractales
Teoría del caos
Juego del caos

lunes, 16 de abril de 2012

Características deseables de números aleatorios

Reforzando un poco mi entrada pasada en la que me falto probar más rigurosamente si los numeros generados con la función random.expovariate(lambd) nos da numeros con características aleatorias deseables.
Para esto se hacen algunas pruebas ya preestablecidas que detecta si el generador de números aleatorios esta generando secuencias de números predecibles.

Elegí el test de frecuencia monobit: Esta prueba detecta si hay muchos ceros o unos.

Código:


Resultado:


Con lo que podemos concluir que expovariate de la librería random si genera números con características aleatorios deseables.

De esta manera completo los test de aleatoriedad que me faltaron la entrada pasada.


Aleatorios en JavaScript

Me interesó hacer una prueba Visual para números aletorios generados en JavaScript, con su función Math.random(), y esto es lo que obtuve generando cerca de 100000 de números:


Código:


Esta prueba nos ayuda a ver de una manera simple si se esta siguiendo algún patrón en los números aleatorios, como no identificamos alguno podemos decir que es un buen generador de números aleatorios.

jueves, 29 de marzo de 2012

Pruebas estadísticas para los números pseudoaleatorios

Lenguaje  a utilizar 


Python


Librería de generación de números pseudoaleatorios


La librería que seleccioné es random de Python, la función random.expovariate(lambd), que el parámetro lambd es un número diferente de 0.


Pruebas 
estadísticas


La prueba estadistica que elegí es: Anderson-Darling
Esta prueba se sefine como:
  • H0: Los datos siguen la distribución especifica(en mi caso exponencial)
  • Ha: Los datos no siguen la solución especifica(en mi caso exponencial)
Esta prueba la apliqué en Python con la librería scipy, módulo stats, función anderson(x, dist='norm'), los parámetros que entran son x = es el arreglo, dist, que es el nombre de la distribución en mi caso 'expon'.

Y los valores que regresa son A2 que es un float , es el valor de la prueba Anderson Darling, critical que es una lista de valores críticos de la distribución, y sig que es el nivel de significancia para el valor crítico correspondiente. La función regresa un valor crítico para diferentes niveles de significancia dependiendo del test.

Esta prueba estadística nos dará el valor de A2 y los valores críticos, estos son los que vamos a comparar para saber si se rechaza o no la hipótesis
Y en la misma librería viene una nota muy importante, que se relaciona con la definición de la prueba Aderson que dice, "Si A2 es más grande que los valores criticos de cada correspondiente nivel de significancia, la hipotesis nula de que los datos provienen de la distrubución elegida puede ser rechazada "


Generar números con python


Ahora vemos el resultado de una ejecución:


Con este resultado podemos ver que en esta prueba no se rechazaron las Hipótesis nulas, entonces los datos están siguiendo  la distribución exponencial.

Características deseables de números aleatorios


He leído algunas sobre las características que se espera que cumplan los números aleatorios, y hay una de ellas que me a llamado la atención, la leí en un documento propuesto por la Doctora, para la solución de esta misma tarea. Esto dice algo así: "a good random number generator will also produce sequences that look nonrandom to the human eye (e.g., a series of ten rolls of six on our die) and which also fail any statistical tests that we might expose it to. ", es decir un buen generador de números aleatorios también producirá secuencias que parecen no aleatorias para el ojo humano y que tampoco sigue pruebas estadísticas.

Entonces para poder concluir si la distribución exponencial es un buen generador de números aleatorios, decidí correr varias veces el programa anterior, para ver si el test siempre dice que sigue la distribución exponencial, o sí hay veces que dice que no la sigue, si es así para mi es suficiente para decir que generar números aleatorios con distribución exponencial es una buena opción. Veamos el programa:


Y lo que vemos es lo siguiente:


Podemos ver que aveces se rechaza la hipótesis nula, pero aveces no, entonces puedo decir que si cumple con características de números aleatorios


Referencias


Scipy, Scipy2
Aleatorios
Teoría Anderson Darling Test


miércoles, 22 de febrero de 2012

Procesos estocásticos discretos y contínuos

Lo que elegí es analizar en una página de Internet que tiene anuncios la probabilidad de que un usuario de click a algún anuncio.
Por ejemplo teniendo 1000 lectores diarios de la página de Internet, solo el 1% de ellos le dará click a algún anuncio, y así es como la página obtiene ganancias. Lo que a mi me interesa saber es la probabilidad de que el usuario numero Y sea el primero en dar click a algún anuncio.
Para elegir que modelo de distribución presenta este fenómeno primero analizare distintas distribuciones continuas y discretas.


Distribuciones discretas y continuas
Las distribuciones discretas son en las que la solución tiene un número determinado de valores.
Ejemplos:
El lanzamiento de una moneda al aire puede salir sol o cara, o si se lanza un dado podemos obtener un número del 1 al 6, si nace un bebe puede ser niño o niña, etc.
Las distribuciones discretas típicas son:
  • El ensayo de Bernoulli
  • La binomial
  • La binomial negativa
  • La geométrica
  • La hipergeométrica

Las distribuciones continuas en las que las soluciones pueden tomar valores infinitos de cierto intervalo.
Ejemplo: El peso de cada integrante de alguna familia (43.3, 55.2, 87,1), o la edad de las personas que toman algún camión (12.3, 45.5, 32.1, 76.4).
Las distribuciones continuas típicas son:
  • Poisson
  • Exponencial
  • Distribución de Gauss o normal

Volviendo al modelo que elegí creo que es una distribución discreta ya estoy buscando simplemente el éxito o el fracaso, es decir si da click o no da click, algo muy parecido al ejemplo de las monedas, o de los dador, usaré para explicar mi modelo la distribución geométrica.

Distribución geométrica
En la distribución geométrica se supone que se lleva a cabo una secuencia de ensayos de Bernoulli independientes, en dónde cada uno tiene la misma probabilidad de éxito "p". "X" es el número de experimentos hasta que se incluye el primer éxito. Entonces X es una variable aleatoria discreta en dónde tenemos una distribución geométrica con parámetro "p".
La podemos expresar X ~ Geom(p).

Ahora mi problema es el siguiente:
En una página web tiene ingresos a través de anuncios publicitarios en la esquina de la página, cada que un usuario da click son ganancias para la página, Si solo el 1% de los usuarios que entran a la página dan click a anuncios, ¿cuál será la probabilidad de que al usuario 2 de el primer click en algún anuncio?

Esto lo podemos representar de esta manera:

P(X = 2) = P(fracaso)(éxito) = P(0.9)(0.1) = 0.09

y de que la 10ma persona de click por primera vez es:

P(X = 10) = P(fr)(fr)(fr)(fr)(fr)(fr)(fr)(fr)(fr)(éxito)
P(0.9)^9 (0.1) = 3.874204889999999e-12

La función que describe esta distribución es:


Ahora para cambiar un poco podemos plantearlo de manera un poco diferente, para tener una probabilidad de 100% de que la persona dará click ¿Cuántos experimentos necesitamos hacer?

La manera de resolverlo es despejando la x de le ecuación, con la fórmula anterior:


Versión continúa de distribución geométrica
La versión continua de esta distribución es: La distribución exponencial. Se utiliza para modelar el tiempo entre eventos sucesivos, o el tiempo requerido para dar servicio a un evento. La distribución exponencial tiene la propiedad de no tiener memoria, es decir, conociendo el tiempo que el último evento ocurrió no se puede predecir cuando el evento siguiente puede ocurrir.


¿Mi modelo puede ser continuo?
Aplicación a mi problema, exactamente con la redacción que tiene no es un fenómeno continuo, pero si se empieza a checar en términos de tiempo, es decir cuantas veces se dio click al anuncio en una hora, o en un minuto, ahí si se convierte en fenómeno continuo.


Código, el código que tomé para hacerlo continuo es el hecho en clase, en dónde tenemos declaradas las variables p (parámetro que significa portabilidad), q que es 1 - p y k que corresponde al intervalo.
De manera discreta observamos algo así para el caso en dónde la probabilidad es .1 y .2, .5 y .9

en las grágicas el color rojo representa la probabilidad 0.1, verde .2, azul .5 y celeste .9.


Ahora para hacerla continua lo primero que se me ocurrió fué reducir el intervalo que es en la variable k, entonces lo hice aumentando .1 en .1 en vez de 1 en 1, y lo que obtuve fué lo siguiente:


Vemos que no se ve muy bien, entonces me di cuenta que para mantener la curva como en la discreta la probabilidad osea p también disminuye, osea si dividí en 10 el avance de k la p también tenia que hacerlo, ya que no es posible que para ahora 1000 intervalos en vez de 100 cada intervalo que se hizo mas pequeño tenga la misma probabilidad que lo que eran 10 veces más grandes, entonces ahora p la dividí entre 10 y obtuve esto:


Aquí están las modificaciones:


Espero comenten y me den algunas ideas para el programa.

Fuentes
Libro: Estadística para Ingenieros y científicos de William Navidi, Capitulo 4.

jueves, 16 de febrero de 2012

PageRank

En esta entrada explico sobre Pagerank

Para empezar dibujé nodos conectados unos a otros aleatoriamente, dando prioridad al nodo 1, para que tenga el pagerank más alto:


Los que yo pensé que tendrían más pagerank los pinté de colores más fuertes:


Así llené la matriz


Gráfica


Ahora obtengo el pagerank


Y vemos que el nodo esperado no es el que tiene más pagerank, entonces empiezo a ponerle 1 a las coordenadas que tienen 0:


Pagerank:


Cambio otro 0 por 1:


Pagerank:


0 por 1


Pagerank:


Ahora vemos que si aumento el pagerank y así es como se ve la gráfica:

jueves, 2 de febrero de 2012

Sistemas deterministas: Un carro


¿Qué es un sistema determinista?


Es cuando conoces la salida de un sistema teniendo sus variables de entrada. En ellos se conoce de antemano, con certeza, el resultado. En estos sistemas el azar no esta involucrado en los estados futuros del sistema.

Entonces conociendo el estado actual del sistema, las variables de ambiente y la forma de comportarse del sistema, entonces se puede saber sin riesgo a equivocarse el estado siguiente del sistema.

Es decir, si se conoce el estado actual del sistema, las variables de ambiente y el comportamiento del sistema ante los cambios en el ambiente, entonces se puede predecir sin ningún riesgo de error el estado siguiente del sistema.
A lo contrario de un sistema no determinista en donde intervienen sistemas aleatorios dificles de controlar o predecir.


Ejemplo: Un carro


Elegí un carro para explicar lo qué es un sistema determinista ya que encuentro mucha relación en el sentido de que los sistemas deterministas podemos predecir el estado siguiente del sistema, el carro es determinista en el sentido que podemos hacer que entren comandos al auto por medio de la manejera, frenos, pedal del acelerador, cambios, luces, limpia parabrisas, claxón, freno de mano, manejar vidrios, alarmas, seguros automáticos, etc.


En un automóvil nosotros elegimos lo que queremos que haga el automóvil en un momento siguiente cercano, como por ejemplo vez una curva, entonces sabes que moviendo la manejera al lado adecuado vas a mover el carro, o cuando vez que el semáforo se puso en rojo sabes que debes de frenar entonces pisas el freno y sabes que el carro va a detenerse, cuando empieza a llover sabes que el carro limpiará el vidrio cuando actives el limpia parabrisas, entre muchas otras cosas.


Un carro es un sistema determinista en el aspecto de hacen lo que nosotros queremos que hagan, y nosotros sabemos como es que el carro reacciona a ciertos movimientos que hacemos para cumplir nuestra finalidad.

Pseudocódigo


El pseudocódigo que cree para esto es:


Ahí explico las principales funciones y variables, claro de una manera muy general y simplificada del sistema de un carro.


Diagrama


En este diagrama muestro las entradas al sistema y las salidas.


Una manera de ver que un carro no es determinista es viendo en cuestión de que no sabemos cuando va a tener tráfico, o cuando se va a ponchar una llanta, ya que eso más bien depende del ambiente y no en si del manejo del automóvil.