Mostrando entradas con la etiqueta Sistemas distribuidos y paralelos. Mostrar todas las entradas

miércoles, 16 de mayo de 2012

Semana 14

Aportación al proyecto hice una investigación de una buena herramienta para crear un grid, con Ganga y Python.


Y para la semana de laboratorio hice también una investigación teórica de Grid.

Grid

Grid Computing

Grid Computing se puede definir como la aplicación de los recursos de muchos ordenadores en una red a un único problema, por lo general una que requiere un gran número de ciclos de procesamiento o el acceso a grandes cantidades de datos.


La red de energía computacional es análoga a la red de energía eléctrica. Permite el acoplamiento de los recursos distribuidos geográficamente para ofrecer un acceso consistente y de bajo costo a los recursos, independientemente de su ubicación física o punto de acceso. Las redes de Internet o dedicados pueden ser utilizados para interconectar una amplia variedad de recursos electrónicos distribuidos (como supercomputadores, clusters de ordenadores, sistemas de almacenamiento, fuentes de datos) y los presentan como un recurso único y unificado.

En su esencia, Grid Computing permite a los dispositivos, independientemente de su funcionamiento a las características de ser prácticamente compartida, gestión y acceso a través de una empresa, industria o grupo de trabajo. Esta virtualización de los recursos pone todo el acceso necesario, los datos y potencia de procesamiento en las yemas de los dedos de los que necesitan para resolver rápidamente problemas complejos de negocios, realizar cálculo intensivo de investigación y análisis de datos, y operar en tiempo real.

Una empresa con un poco menos de 2.000 computadoras de escritorio pueden cosechar cerca de 1 teraflop (un billón de operaciones de punto flotante por segundo) de capacidad de computación. Aún mejor, la compañía puede capturar el poder de las computadoras que ya posee de que fuera de uso por la noche y el trabajo en menos de plena capacidad durante el día.

Universidades e instituciones de investigación han utilizado durante mucho tiempo la red de computación en la tecnología, pero recientemente también está haciendo avances rápidos en el mercado empresarial. IBM acaba de llegar a las normas de funcionamiento que va a generar muchas nuevas aplicaciones de negocios y hará que la proliferación de ancho.

Internet de Grid Computing

El Internet está evolucionando más allá del correo electrónico, contenido y comercio electrónico. Se está convirtiendo en una verdadera plataforma, que combina las cualidades de servicio de la computación empresarial con la capacidad de compartir recursos distribuidos a través de la web: aplicaciones, datos, almacenamiento, servidores, y todo en el medio.
Habilitación de dispositivos: Internet amplió la gama de cosas que los ordenadores personales puede hacer, aprovechando sus funciones de comunicación para poner servidores para trabajar el almacenamiento de archivos de copia de seguridad, servicio de páginas web personales y de bloquear el spam. Sin embargo, la computadora personal, asistente personal digital (PDA) u otros dispositivos conectados no tienen acceso transparente a todos los tipos de programas en todo tipo de plataformas. Las aplicaciones que acceden a que no están necesariamente integrados. La computación Grid mantiene la promesa de traer este tipo de poder y la capacidad de dispositivos habilitados para Internet. En un mundo inalámbrico, esta red podría permitir a los dispositivos más simples, tales como buscapersonas - para acceder a la potencia de los ordenadores a través de la red de una manera significativa.


La intensa colaboración: Hoy en día, la colaboración en línea proporciona uso compartido de documentos y permite a los debates. Este proceso va a cambiar con el grid computing, lo que facilitará la utilización conjunta de las solicitudes completas. A pesar de esto tiene gran uso de sofisticadas aplicaciones de colaboración, incluso las aplicaciones mundanas se beneficiarán. Por ejemplo: los patrones pueden ser detectados en el uso de recursos financieros, mejoras para el hogar, planificación de eventos y otras aplicaciones, y todas las aplicaciones relacionadas se beneficiarán de las opciones identificadas, y se tomen decisiones, las personas con necesidades similares. Muchos tipos de simulación, incluyendo prototipos, puede ser posible gracias a la computación grid. Esto animará a nuevas relaciones y nuevas comunidades.
Además de nuevas capacidades, hay un gran potencial para el ahorro de costes. Uso de los ciclos de repuesto (el tiempo de inactividad en el equipo), en paralelo con los ataques a los problemas, el acceso a través de dispositivos más sencillos y utilizar sólo las funciones de la aplicación que necesita debe hacer la mayoría de las aplicaciones de tecnología de la información más económico y asequible en el futuro.


Aplicaciones

Toda el área de la computación distribuida es una cama caliente de desarrollo significativo que se espera que genere avances sorprendentes en los próximos años. Y los primeros grandes aplicaciones ya están aquí.
United Technologies, el conglomerado de fabricación $ 28b, está equipando a más de 100.000 computadoras Wintel con su propio peer-to-peer software para hacer cálculos científicos y resuelve problemas complejos de modelado durante las horas libres. El proyecto es una ampliación de lo que la compañía de aviones Pratt & Whitney división de motores ha hecho para eliminar una supercomputadora Cray con 5.000 estaciones de trabajo Sun Unix, para llevar a cabo simulaciones de diseño de piezas de aviones. El resultado: el 85 por ciento de utilización para cada estación de trabajo.

Con 20.000 PCs en Pratt & Whitney, el proyecto P2P se espera reducir a la mitad el tiempo y el dinero que se necesita para desarrollar motores de turbina y otras partes de aviones, principalmente mediante la eliminación de varios millones de dólares prototipos. Anteriormente, se podría tomar $ 1 mil millones y cinco años entre el momento en un motor ha sido desarrollado y certificado.

Universidades y organizaciones de investigación han utilizado similares de procesamiento de igual enfoques para resolver problemas científicos complejos. El más famoso es un proyecto denominado SETI @ home, que utiliza los equipos de voluntarios en todo el mundo para buscar vida en otros planetas.

El Programa Intel filantrópica P2P ayuda a combatir enfermedades potencialmente mortales mediante la vinculación de millones de ordenadores en lo que se prevé que el recurso de computación más grande y rápido de la historia. Este "supercomputadora virtual" utiliza la tecnología P2P para hacer cantidades sin precedentes de poder de procesamiento disponibles para los investigadores médicos para acelerar el desarrollo de mejores tratamientos y medicamentos que podrían curar enfermedades.


miércoles, 9 de mayo de 2012

Seguridad con IPython

Wiki


Paquete de Python IPython.zmq expone toda la potencia del intérprete de Python en una red TCP / IP a los efectos de la computación paralela. Esta característica nos lleva a la importante cuestión de modelo de seguridad de IPython. Este documento da detalles acerca de este modelo y cómo se lleva a cabo en la arquitectura de IPython.


Proceso y topología de la red
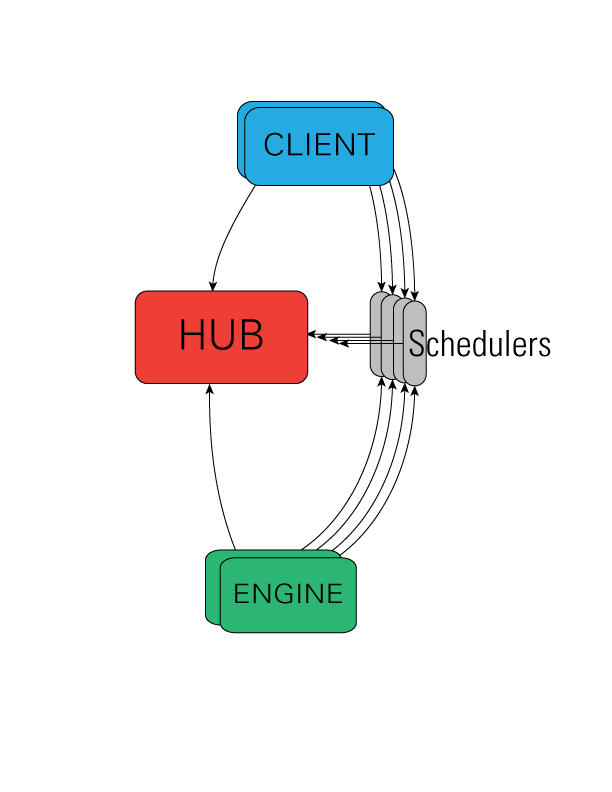
Para habilitar la computación paralela, IPython tiene una serie de diferentes procesos que se ejecutan. Estos procesos se discuten en detalle en la documentación IPython y se resumen aquí:


  • El motor IPython. Este proceso es un completo intérprete de Python en el que se ejecuta código de usuario. Varios motores hacen posible la computación paralela.
  • El centro IPython. Este proceso controla un conjunto de motores y programadores, y comprueba el estado de los procesos. Se escucha por conexiones de registro de los motores y los clientes, y las conexiones del monitor de los programadores.
  • Los programadores ipython. Se trata de un conjunto de procesos que transmiten los comandos y los resultados entre los clientes y los motores. Por lo general son en la misma máquina que el controlador, y escuchar las conexiones de los motores y los clientes, sino conectar con el Hub.
  • El cliente IPython. Este proceso es típicamente un proceso interactivo Python que se utiliza para coordinar los motores para obtener un cálculo paralelo.

En conjunto, estos procesos se denominan el grupo IPython, y el cubo y programadores juntos se conocen como el controlador.

Estos procesos se comunican a través de cualquier transporte con el apoyo de ZeroMQ (tcp, pgm, Infiniband, el IPC) con una topología bien definida. El centro IPython y programadores de escuchar en los sockets. Al iniciarse, el motor se conecta a un hub y se registra, que a su vez informa al motor de la información de conexión para los programadores, y el motor se conecta a los programadores. Estas conexiones del motor / eje y motor / programador deben persistir durante la vida útil de cada motor.

El cliente IPython también se conecta con los procesos de mando mediante un número de conexiones de socket. Como la escritura, este es un zócalo por programador (4), y 3 conexiones al centro de un total de 7. Estas conexiones persistir durante la vida útil del único cliente.

Un controlador IPython dado y un conjunto de motores de motores típicamente tiene una vida relativamente corta. Típicamente esta vida corresponde a la duración de una sola simulación paralela a cabo por un solo usuario. Por último, el centro, los programadores, los motores, y los procesos de los clientes por lo general se ejecutan con los permisos de ese mismo usuario. Más específicamente, el controlador y los motores no se ejecutan como root o con permisos de superusuario.

Conexiones de red seguras
Información general


ZeroMQ no proporciona exactamente ninguna seguridad. Por esta razón, los usuarios de IPython debe ser muy cuidadoso en el manejo de las conexiones, ya que un proceso abierto socket TCP / IP presenta el acceso a la ejecución arbitrario como el usuario en las máquinas de motor. Como resultado, el comportamiento predeterminado del controlador de procesos es escuchar sólo para los clientes en la interfaz de bucle invertido, y el cliente debe establecer túneles SSH se conecten a los procesos de controlador.

SSH
Desde ZeroMQ no proporciona ninguna seguridad, los túneles SSH son la principal fuente de conexiones seguras. Un archivo de conexión, como ipcontroller-client.json, contendrá información para la conexión al controlador, que pueden incluir la dirección de un servidor ssh a través con el cliente es hacer un túnel. El objeto del cliente crea túneles que utilizan ya sea OpenSSH o Paramiko, dependiendo de la plataforma. Si los usuarios no desean utilizar OpenSSH o Paramiko, o las utilidades de túneles no son suficientes, entonces se puede construir los túneles de sí mismos, y simplemente conectar a los clientes y los motores, como si el controlador se encontraban en bucle de retorno en el equipo de conexión.


Otras medidas de seguridad
Un número de otras medidas se toman para limitar aún más los riesgos de seguridad involucrados en el funcionamiento del kernel IPython.

En primer lugar, de forma predeterminada, el controlador IPython escucha en números de puertos aleatorios. Si bien esto puede ser anulado por el usuario, en la configuración predeterminada, el atacante tendría que hacer un escaneo de puertos para encontrar incluso un controlador para atacar. Cuando se combina con el tiempo relativamente corto de funcionamiento de un controlador típico (del orden de horas), el atacante tendría que trabajar muy duro y muy rápido para encontrar incluso un controlador en marcha para atacar.

En segundo lugar, la mayor parte del tiempo, especialmente cuando se ejecutan en supercomputadoras o clusters, el controlador se ejecuta detrás de un firewall. Por lo tanto, para los motores o el cliente para conectarse al controlador:

Los diferentes procesos tienen que estar todos detrás del firewall.
o bien:

El usuario tiene que utilizar el reenvío de puerto SSH para hacer un túnel las conexiones a través del firewall.
En cualquier caso, un atacante se presenta con barreras adicionales que impiden atacar o incluso el sondaje.


Referencias

iPy


Nominaciones:

Juan Carlos Espinoza

MPI con IPython


A menudo, un algoritmo paralelo requiere movimiento de datos entre motores. Una forma de conseguir esto es haciendo un tirón y luego un empujón con el cliente multimotor. Sin embargo, esta será lenta como todos los datos tienen que pasar por el controlador para el cliente y luego de vuelta a través del controlador, a su destino final.

Una manera mucho mejor de mover datos entre los motores es el uso de una biblioteca de paso de mensajes, como la interfaz de paso de mensajes (MPI). Arquitectura de cómputo paralelo IPython ha sido diseñado desde cero para integrarse con MPI.


Requisitos adicionales de instalación

  • El estandar MPI como OpenMPI o MPICH.
  • El mpi4py paquete.

Inicio de los motores con MPI


Para utilizar el código que llama a MPI, normalmente hay dos cosas que MPI requiere.

  • El proceso que se quiere llamar a MPI se debe iniciar con mpiexec o un sistema de proceso por lotes (como PBS), que cuenta con el apoyo de MPI.
  • Una vez iniciado el proceso, se debe llamar a MPI_Init ().

Hay un par de maneras para comenzar a los motores de ipython y conseguir que estas cosas pasen.

Arranque automático con mpiexec y ipcluster


El enfoque más sencillo es utilizar los lanzadores de MPI en ipcluster, que primero se iniciará un controlador y, a continuación un conjunto de motores que utilizan mpiexec:

$ ipcluster start -n 4 --engines=MPIEngineSetLauncher

Este enfoque es mejor que la interrupción de ipcluster se detendrá automáticamente y limpiará el controlador y los motores.

Empezar manualmente a usar mpiexec

Si desea arrancar los motores ipython utilizando el mpiexec, lo que hay que hacer es:

$ mpiexec -n 4 ipengine --mpi=mpi4py


Esto requiere tener un controlador en marcha y que los archivos FURL para los motores están en su lugar. También se ha construido en apoyo a PyTrilinos , que se puede utilizar (suponiendo que se instala) por el arranque de motores con:

$ mpiexec -n 4 ipengine --mpi=pytrilinos


Una vez que los motores están funcionando con el MPI, que están listos para ir. Ahora se puede llamar a cualquier código que utilice MPI en los motores de ipython. Y, todo esto se puede hacer de forma interactiva. Este es un muy sencillo ejemplo de la página oficial.

En primer lugar, permite definir una función simplemente que utiliza MPI para calcular la suma de una matriz distribuida. Y guarda el texto en un archivo llamado psum.py:


Referencias

iPy

jueves, 3 de mayo de 2012

Javascript paralelo

StratifiedJS extiende el lenguaje JavaScript con un pequeño número de construcciones de programación concurrente. Le permite expresar el flujo de control asíncrona en un estilo secuencial sencillo:


En ese código lo que se intenta recuperar las noticias de la BBC, al mismo tiempo trata de la CNN si no se recibió la noticia después de 1 segundo muestra la primera noticia que llega, y cancela cualquier solicitud que todavía podría estar en espera el tiempo de espera después de 1 minuto si no hay noticias recibidas, de forma automática la cancelación de las solicitudes pendientes.


StratifiedJS ejecuta el código en unidades lógicas que llamamos estratos. A diferencia de lo normal el código JS, los estratos se les permite "bloquear", es decir, el flujo de control se le permite detenerse en un punto determinado para ser recogidos más tarde en el mismo punto donde lo dejó. Un ejemplo sería la instrucción espera que bloquea por un período de tiempo dado.
Mientras que un estrato está bloqueado, puede ejecutar otros estratos. Los estratos son un poco como las discusiones, pero son mucho más determinista: un único estrato se está ejecutando en un momento dado y se ejecuta atómicamente hasta el punto en que o bien acabados o suspende. En ese punto el siguiente estrato pendiente se ejecuta hasta que termina o suspende, y así sucesivamente.
StratifiedJS contiene construcciones para la fundición de lógica asincrónica en forma de bloqueo (waitfor ()) y construcciones para la combinación de múltiples estratos (waitfor / y, waitfor / o desove) de una manera estructurada.

La función de StratifiedJS espera puede ser llamada con un argumento t el número de suspender el actual estrato de ~ t milisegundos:

La función de StratifiedJS espera puede ser llamada con un argumento t el número de suspender el actual estrato de ~ t milisegundos:
hold(1000);


Se debe tener en cuanta que sólo suspende el estrato que aparece en, que no bloquea todo el programa y no lo hace 'ocupado espera'. Otras capas simultáneas puede continuar para ejecutar durante este tiempo. Si está ejecutando SSJ en un navegador, la interfaz de usuario se quedará plenamente sensible durante los períodos de suspensión.


Referencia

http://onilabs.com/stratifiedjs

miércoles, 2 de mayo de 2012

Semana 13

Esta semana para la clase, he encontrado una herramienta que pudiera ser e verdader útilidad para el equipo, parece tener un gran soporte para sistemas paralelos y distribuidos, su nombre es iPy.
Explico su funcionalidad, arquitectura, y uso en el Wiki, aquí el enlce.

Para laboratorio hice una entrada, referente a la programación paralela en Javascript <3.
Esta es la entrada.


Nominaciones:

Roberto

lunes, 30 de abril de 2012

Cena de filosofos

Para esta semana de Laboratorio implemente exitosamente y por fin, el problema de la cena de filosofos, este es el código:


Y muestra de su ejecución:


domingo, 29 de abril de 2012

Semana 12

Aplicación de Sistemas Distribuidos y Paralelos

Para esta semana investigue sobre aplicaciones que tiene la computación paralela y distribuida en la química.

Las técnicas computacionales están siendo utilizados cada vez más como una alternativa al experimento en química. En lo que se llama ab initio la química cuántica, los programas de ordenador se utilizan para calcular las propiedades fundamentales de los átomos y las moléculas, como la fuerza de adhesión y las energías de reacción, a partir de primeros principios, mediante la resolución de una serie de aproximaciones a la ecuación de Schrödinger que describe sus estructuras básicas.


Este enfoque permite el químico para explorar vías de reacción que sería peligroso o costoso para explorar experimentalmente. Una aplicación de estas técnicas es en la investigación de procesos biológicos.

Y para laboratorio implementé un código de la cena de filosofos en python.

Nominaciones:
Ramón
Ave
Gaby
Roberto

miércoles, 18 de abril de 2012

Semana 11

Esta semana mi contribución fué la investigación a otra buena opción como herramienta a usar, en el lenguaje que ya fué acordado Python, se llama superpy "Supercomputing and parallel processing for python".
Este es el link al wiki: Superpy

Imágenes de entrada:


Demo


Y para laboratorio hice una entrada para hablar de una útil herramienta, desarrollada con la misma librería de python
Este es el link al blog: http://cecilia-urbina.blogspot.mx/2012/04/pyfog-es-una-aplicacion-que-usa-superpy.html


Nominaciones: Juan Carlos por su buena contribución de esta semana, Gaby y Roberto

domingo, 15 de abril de 2012

Semana 10

La contribución que hago esta semana es referente a un lenguaje de programación llamado SISAL del que investigue un poco. Para esto primero defino algunos conceptos importantes.


Paralelismo implicito

En informática, el paralelismo implícito es una característica de un lenguaje de programación que permite a un compilador o intérprete para explotar de forma automática el paralelismo inherente a los cálculos expresados ​​por algunas de las construcciones del lenguaje. Un lenguaje puro implícita paralelo no tiene por qué las directivas especiales, operadores o funciones que permitan la ejecución en paralelo.

Algunos lenguajes con paralelismo implícito son Axum, HPF, Id, LabVIEW, MATLAB M-code, NESL, SaC, SISAL, ZPL, y pH.

Ventajas

Un programador que escribe código de forma implícita en paralelo no tiene que preocuparse acerca de la división de tareas o el proceso de comunicación, centrándose en cambio en el problema de que su programa está destinado a resolver. Paralelismo implícito en general, facilita el diseño de programas paralelos y de los resultados, por lo tanto en una mejora sustancial de la productividad del programador.

Desventajas

Lenguajes con paralelismo implícito reduce el control que el programador tiene sobre la ejecución en paralelo del programa, lo que resulta a veces en menos que óptimo de eficiencia en paralelo.

SISAL

SISAL (Streams and Iteration in a Single Assignment Language) es un lenguaje de propósito general una sola asignación funcional de programación con la semántica estricta, paralelismo implícito, y el manejo conjunto eficiente. SISAL genera un gráfico de flujo de datos en el formulario Intermediario 1 (IF1). Fue derivado de Val (orientado hacia el valor lenguaje algorítmico, diseñado por Jack Dennis), y añade las corrientes de recursividad y finito. Tiene una sintaxis similar a Pascal y fue diseñado para ser un común lenguaje de alto nivel para los programas numéricos sobre una gran variedad de multiprocesadores.

SISAL fue definido en 1983 por James McGraw, en la Universidad de Manchester, LLNL, Colorado State University y en diciembre ha sido revisado en 1985, y la primera aplicación compilada se hizo en 1986. Su rendimiento es superior a C y Fortran rivales, según algunas fuentes, en combinación con la paralelización eficiente y automática.

El SISAL es un lenguaje funcional de programación paralela. Combina las características modernas del lenguaje con una sintaxis legible y matemáticamente sólidas bases semánticas para proporcionar la forma más fácil de vehículo para la programación paralela. Su compilador de optimización en tiempo de ejecución y el software de apoyo al sistema ofrece la portabilidad, de alto rendimiento y comportamiento de ejecución determinado. Está disponible en todos los monoprocesador basado en Unix y los sistemas de memoria compartida con varios procesadores, y las versiones de desarrollo existen para varios sistemas de memoria distribuida, también.

Link de descarga


Tutorial


miércoles, 4 de abril de 2012

Distributed and parallel systems Extra Points

1. In which case is it straightforward to modify a recursive algorithm into a parallel one?
When the data are highly dependent, ie the result of the next iteration depends on the previous iteration

2. When is it impossible to turn an algorithm into a parallel one?
When there are inter-task dependencies

3. How will a process know when a thread that it previously forked finishes execution?
By using communication and synchronization between threads

4. Why do multi-threaded programs sometimes run slower than single-threaded versions?
The fact that the algoritms can be parallelized doesn't mean that they are optimal, sometimes the algoritmo is optimal only when there is a lot of data because when there is a little amount of data, it could take longer distributing tasks than running the code.

5. How does one ensure that one thread printing will not mess up another thread’s printouts?
By using locks that protect critical parts of code

Semana 9

Propuesta para el equipo Cluster

Esta semana en clase investigue un poco herramientas en python que facilitaran esta tarea, a lo que encontré una librería llamada Pycluster.
Para instalarla se siguen los siguientes pasos:

  1. Descarga del paquete.
  2. Descomprimes (sudo tar xzvf Pycluster-1.50.tar.gz)
  3. Ahora dentro de la carpeta creada, instalamos 
cecy@cecy-Inspiron-N4020:~/Downloads/Pycluster-1.50$ sudo python setup.py install


Y probamos si todo esta bien con el comando:
cecy@cecy-Inspiron-N4020:~/Downloads/Pycluster-1.50$ python setup.py test


Este es un buen manual sobre como se usa la librería: http://bonsai.hgc.jp/~mdehoon/software/cluster/cluster.pdf


Semana 9 de aportación en el Wiki

Entrada para laboratorio de esta semana, hablando de como se usa pypar para comunicar programas en paralelo.


Nominación para:
Roberto por su aportación de comportamiento de algoritmos paralelos.

jueves, 22 de marzo de 2012

Semana 8

Proyecto grupal final Ideas

Platiqué con algunos de mis compañeros que si fueron a la junta y me hablaron tentativamente del proyecto que estaremos realizando como entrega final, basandonos en las funcionalidades que hace esta página http://www.leetcode.com/ y distribuyendo el trabajo en varias computadoras para mandar las respuesta necesaria.


Y propongo algunas buenas herramientas y lenguajes que debemos usar para esto:

Parallel Python: Me parece una herramienta excelente para que haga el trabajo de distribuir y paralelizar el código en un cluster, así nosotros no nos preocuparíamos de muchas cosas, además de que ya gente en el grupo hemos estado trabajando con la herramienta y estamos familiarizados con ella.

Javascript: Usar JS + HTML5 + CSS , será posible crear el aspecto de estar verdaderamente en alguna terminal ejecutando código, creo que debemos empezar a ver este aspecto ya que aparentemente será el más fácil pero no lo debemos dejar para el último momento.

Dispy: es un marco, desarrollado en Python, para la ejecución en paralelo de los cálculos mediante la distribución de ellos a través de múltiples procesadores en una sola máquina (SMP), entre muchas máquinas en un clúster, la red o las nubes. Dispy es muy adecuado para los datos de paralelismo (SIMD paradigma) cuando se evalúa un cálculo con diferentes (grande) conjuntos de datos de forma independiente.  

Nominaciones:

Solamente a Roberto Carlos y Gabriela Martínez(entrada sobre junta)por ponerme al tanto con la junta.

(si esque esto deba de ir en el wiki, estoy tratando aún de recordar mi contraseña)


miércoles, 21 de marzo de 2012

Semana 7

Esta semana me dí a la tarea de investigar cuando es correcto paralelizar código, esto debido a que como estoy en el equipo que debe programar es importante saber cuando si se puede hacer y cuando no.
Y las cosas que debemos saber para cuando este listo el cluster y poder pasar los programas que simulan procesos en hilos a programas que se ejecuten en procesos de diferentes máquinas.

Se tiene que analizar si se cuenta con el hardware y software necesario para determinar se si vale la pena paralelizar el programa o viceversa.

En cuestiones de equipamiento el proceso de paralelizar un programa nos exigira conocer un poco más de la arquitectura de la supercomputadora o "cluster" sobre el cual pretende paralelizar su código, conocer con cuantos procesadores se cuenta, la cantidad de memoria, espacio en disco, los niveles de memoria disponible, el medio de interconexión, etc.

En términos de software debemos conocer qué sistema operativo se manejará, si los compiladores instalados permiten realizar aplicaciones con paralelismo, si se cuenta con herramientas como PVM o MPI en sistemas distribuidos.


Para saber si vale la pena el paralelismo en un programa, podemos identificar nuestra situación con las siguientes justificaciones:


1.Necesidad de respuesta inmediata de resultados.

Si el usuario está usando un programa en una máquina secuencial, y necesita ejecutarlo en varias ocasiones con datos de entrada diferentes, y el tiempo de ejecución es considerable (consume horas o días) le es molesto esperar tanto tiempo para volver a realizar otro experimento o someterlos secuencialmente que al final disminuirá notablemente el desempeño de su máquina. Esto sin considerar las modificaciones al código o fallas en la ejecución del modelo. La paralelización y la ejecución del programa en una máquina paralela permitirá realizar más análisis o experimentos en menos tiempo.

2.Es un problema de Gran Reto.

Un programa puede presentar algoritmos de cálculo científico intensivo que demanden grandes recursos de cómputo (CPU, memoria, disco), en estos casos el dicho de "divide y vencerás" bien se puede aplicar, las tareas se dividen entre varios procesadores, se ejecutan en paralelo y se obtiene una mejora en la relación costo y desempeño. Hoy en día las arquitecturas de cómputo estan incorporando paralelismo en los más altos niveles de sus sistemas, para satisfacer las exigencias de los problemas de grandes retos.

3.Simplemente elegancia de programación.

Es completamente válido.

Para implementar paralelismo a un programa es muy importante que el código presente:

Independencia de datos. Como programadores  debemos saber  identificar tareas independientes dentro del código, por ejemplo, revisar que existan ciclos for o do independientes, y rutinas o módulos independientes. De tal forma que no exista dependencias de datos que puedan obstruir la paralelización.
Que el programador identifique las zonas donde se efectúa la mayor carga de trabajo y que le consuma la mayor parte de tiempo de ejecución.

Es todo por esta semana espero, mis compañeros se den la oportunidad de leerlo, ya que menciono algunos puntos que debemos tener en cuenta para empezar a hacer que nuestro código corra en clústers y saber cuando vale la pena paralelizar.


Referencias

Paralelización

domingo, 11 de marzo de 2012

Cálculo del pi en paralelo

En esta semana quise complementar lo de algoritmos paralelos haciendo un algoritmo que calcula el número Pi primero en paralelo y después en secuencial.

Metodo de Montecarlo

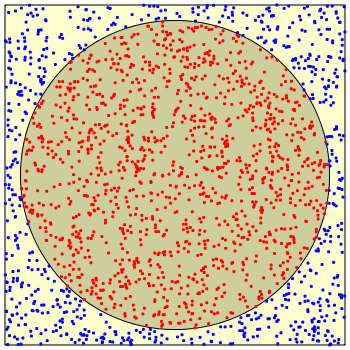
Este algoritmo consiste en generar experimentos aleatorios independientes consistentes en generar N puntos x, y que pertenezcan de 0 a 1 y contabilizar C los números que caen dentro del cuadrante de un circulo de radio 1.


El área del circulo es igual a pi*radio **2, el área del cuadrante es pi/4, y la probabilidad es C/N = pi/4 osea pi = 4C/N.

La aproximación más precisa es cuando N tiende al infinito.
Este es el algoritmo secuencial que desarrolle:


Ejecución:


Paralelización

Este reparto consiste en la generacion de N experimentos en un conjunto de P procesadores. Cada procesador puede generar puntos y contar cuales C caen en el rango del círculo con 1 de radio.
Al iniciar solo el proceso principal conoce cuales son los valores de N, osea el número de pruebas que se quiere hacer, y cuantos procesadores se van a tener.
Después se envian a los procesos esclavos la N, para que empiezen a calcular.

Cada proceso realiza el trabajo que le corresponde


Y por último los procesos esclavos envían sus resultados al proceso maestro, para que el maestro calcule el numero de aciertos y lo multiplique por 4 (por la formula que acabamos de ver) y lo divida entre el total de experimentos N.

Mi programa en python emula este comportamiento con hilos, y queue de python para poder mandar cada suma al proceso maestro, este es el programa:


En donde señale que sean 5 procesadores, osea 5 hilos que realicen la tarea indicada.
Y la ejecución se ve así:


El algoritmo lo desarrolle tomando la lo propuesto en este pdf, donde proponen la realización de él más no códigos ni pseudocódigos.

Semana 6

Paralelizando algoritmos

Criba de Eratóstenes

Es un aloritmo que encuentra numeros primos de 2 a N, empieza con el número 2 y tacha todos los elementos que son multiplos del 2, una vez que tacho todos estos sigue el elemento que no ha sido tachado despues de dos y así sucesivamente.


Primero desarrollé la versión en secuencial del algoritmo en Python:


Ejecución:


Para paralelizarla lo que intenté hacer fué que cada hilo buscara los múltiples de ciertos números en paralelo. Es decir mientras uno buscaba los múltiplos de 2 otro buscara los múltiplos de 3 y así sucesivamente.


En el ejemplo lo hice con solo un hilo, con esta manera de implementación podemos crear tantos hilos como queramos y que empiecen a checar si es primo o no desde algún número, y así trabajar en paralelo, subiré la parte en donde muestro como se hace de esta forma que explico en otra entrada, esto es todo por ahora.

Nominaciones:
Por ahora solo, Roberto Martínez por la propuesta al uso de una herramienta útil para hacer sistemas distribuidos y Emmanuel por la explicación del uso de mpi4 de python ya que yo tenía pensado hablar de eso.


miércoles, 29 de febrero de 2012

Semana 5

Mi aportación en esta semana fue seguirle mejorando al mergesort que hice en python pero no tuve mucho éxito de nuevo, algo me esta faltando poner que los threds se confunden todos y mezclan las listas,  ya traté de poner identificadores en los threads, también use locks.. pero algo me sigue faltando.. dejo algunas capturas de pantalla de la corrida del programa para poder adjuntarlas en el wiki..

Aquí esta mi entrada completa en el wiki, espero puedan checar los códigos y darme su opinión.

Lo que tengo propuesto hacer para la próxima semana es hacer funcionar esto por fin, y un paint que se pueda manejar en varias computadoras.


jueves, 23 de febrero de 2012

Semana 4

Para esta semana probé una herramienta que nos puede ser muy útil para los clusters.
Parallel python, es lo que mostramos el martes en clase, en el wiki explico los pasos para la instalación y correr los programas en las computadoras.

Wiki


lunes, 13 de febrero de 2012

MergeSort

Semana 3
Para esta semana programé el algoritmo de mergesort secuencial y paralelo.
Esta es la liga al wiki.

Nomino esta semana a Roberto
http://elisa.dyndns-web.com/progra/Matrix

Gaby
http://elisa.dyndns-web.com/progra/CUDA

Ramon Esteban

jueves, 9 de febrero de 2012

Semana 2

Mi contribución de esta semana, es un programa que considero útil para probarlo con el cluster cuando este funcional, se trata de un programa en python que creo hilos recursivos, cada uno creando una imágen, el programa simula la infección de un virus por medio de un grafo, en el cual podemos ver los estados de la infección, crea alre\ dedor de 500 hilos, con 100 nodos.

Esta es la liga al wiki: